TL;DR
Les 4 signaux
🔒 Datasette patch deux branches en urgence
 Deux versions de sécurité sortent simultanément : 1.0a39 pour la série alpha et 0.65.4 pour la branche stable 0.65.x. Les correctifs ciblent les instances Datasette exposées sur le web public 6.
Pourquoi ça compte : si vous faites tourner Datasette en prod publique, migrez sur 1.0a39 ou 0.65.4 sans attendre.
📱 Shopify repasse au natif
 Shopify migre de React Native vers des bases de code Swift et Kotlin séparées. La décision de 2020 visait à éviter de construire deux fois les mêmes features et à permettre aux devs web de contribuer au mobile 8.
Pourquoi ça compte : signal inverse pour les équipes qui parient sur le cross-platform — le coût de maintenance finit par dépasser le gain de mutualisation.
🖥️ T1 : agent terminal en RL sur 122B paramètres
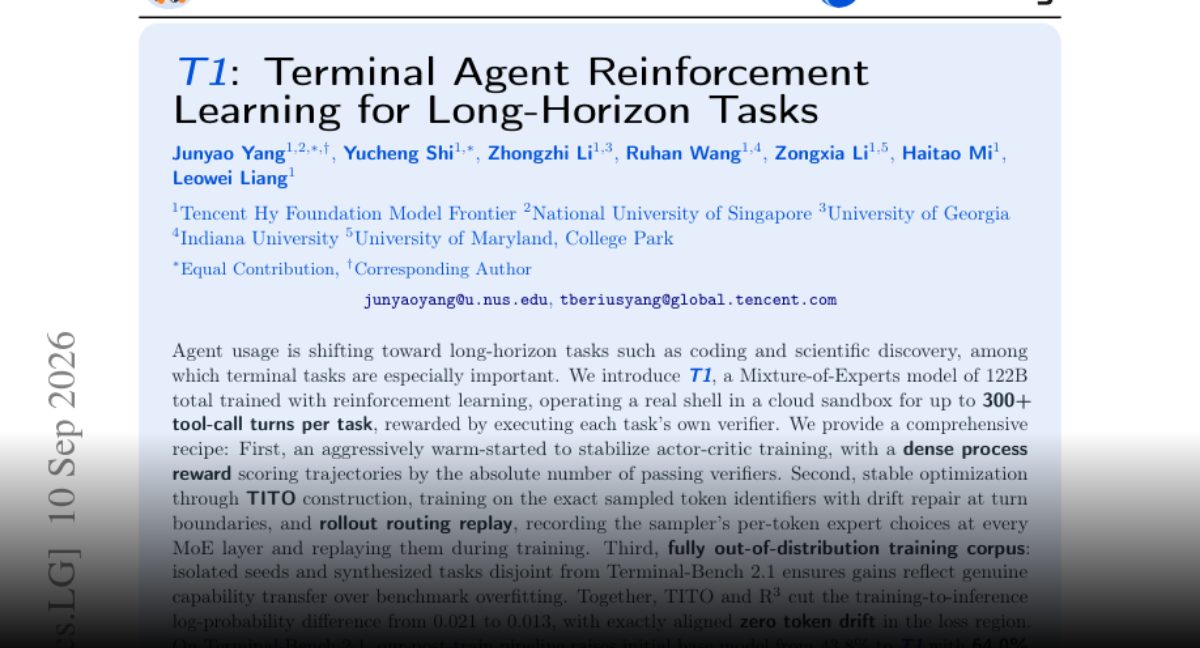 T1 est un modèle Mixture-of-Experts de 122B paramètres entraîné par RL, opérant un shell réel dans un sandbox cloud sur 300+ tours d’appels d’outils par tâche. Cible : tâches long-horizon type coding et découverte scientifique 16.
Pourquoi ça compte : le RL sur environnement shell réel devient une recette publiée pour agents long-horizon — à surveiller pour tout pipeline d’automatisation dev.
🧮 HyQuant : quantification hybride de l’attention HyQuant cible la quantification basse précision du module d’attention, où les erreurs explosent aux très faibles bit-widths. Les méthodes existantes s’appuient sur du smoothing pour gérer les outliers 13. Pourquoi ça compte : si vous servez des LLM quantifiés, l’attention est le goulot de dégradation — une piste directe pour baisser les coûts d’inférence sans perdre en qualité.
À retenir
Tuto du jour
Aucun tuto d’installation locale identifié aujourd’hui.
Matos & Infra local
Sujet Matos/Infra : HyQuant, quantification hybride pour l’attention LLM 13 Constat technique : La quantification basse précision du module d’attention introduit des erreurs importantes aux très faibles largeurs de bits, dégradant les performances ; les méthodes existantes reposent surtout sur du lissage des valeurs aberrantes 13. Recommandation dev : Tester HyQuant avant de descendre en dessous de 4 bits sur l’attention en inférence locale 13.
Fine-Tuning & Quantiz
Technique / Outil : HyQuant, quantification hybride de l’attention 13 Apport : réduit les erreurs de quantification bas-bit de l’attention, là où les méthodes par lissage peinent sur les outliers 13 Impact pratique : appliquer une précision mixte à l’attention pour limiter la dégradation à très faible bit-width 13
RAG & Agents Locaux
Architecture / Outil : OreoLook (ex-lixSearch), moteur de réponse open source à agents navigateur et inférence LLM routée par fournisseur 4 Cas d’usage : recherche web augmentée par LLM à faible latence, exécutée sur matériel CPU standard, avec cache local et sessions 4 Clé de voûte : architecture de cache à trois couches pour réduire la latence sur CPU commodity 4
Track Record
Ce qu’on disait le 2026-08-28 : « Claude Code passe l’auto mode par défaut, Anthropic parie sur sa protection contre les injections prompt 1 » Verdict aujourd’hui : en attente. Aucun élément du jour ne confirme ni n’infirme ce pari. Les travaux publiés cette semaine sur la sécurité des agents vont dans le même sens — EvoSafeHarness 12 et SchemeArena 18 traitent des injections indirectes et du scheming — mais sans donnée sur Claude Code.
Sources (18) — vérifiées le 11/09/2026 05:01 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | Ce que les IA d’OpenAI se sont raconté en se croyant seules | Korben | 10 septembre 2026 |
| 4 | A Three-Layer Caching Architecture for Low-Latency LLM Web Search on Commodity CPU Hardware | HF Papers | |
| 6 | Datasette 1.0a39 and 0.65.4 security releases | Simon Willison | 11 septembre 2026 |
| 8 | Native is now the future of mobile at Shopify | Simon Willison | 10 septembre 2026 |
| 12 | EvoSafeHarness: Evolving Model- and Domain-Specific Harnesses for Securing Agents | HF Papers | |
| 13 | HyQuant: Hybrid-Precision Quantization for LLM Attention | HF Papers | |
| 16 | T1: Terminal Agent Reinforcement Learning for Long-Horizon Tasks | HF Papers | |
| 18 | SchemeArena: Factorized Stress Testing of Scheming in LLM Agents | HF Papers |
Autres lectures (10)
| N° | Publication | Site | Date |
|---|---|---|---|
| 2 | When will average people feel AI’s impact? | Interconnects | 9 septembre 2026 |
| 3 | PARSER: Read in Parallel, Reason in Depth for Long-Context LLM Agents | HF Papers | |
| 5 | No Man’s Sky Cosmos | Hacker News | 9 septembre 2026 |
| 7 | Any Nix package, live in your browser | Simon Willison | 10 septembre 2026 |
| 9 | Quoting Calif Research | Simon Willison | 10 septembre 2026 |
| 10 | .blend URL Viewer | Simon Willison | 9 septembre 2026 |
| 11 | Get ready for the game with new football features in Search | Google AI | 9 septembre 2026 |
| 14 | An Open Recipe for IMO Gold: Training Nemotron for Olympiad Mathematics | HF Papers | |
| 15 | World in World: Explore the World with World Models | HF Papers | |
| 17 | Scaling Automatic Research Agents via World Models | HF Papers |
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.