TL;DR
Les 3 signaux
🧠 Claude Fable 5.1
focus science et exécution longue
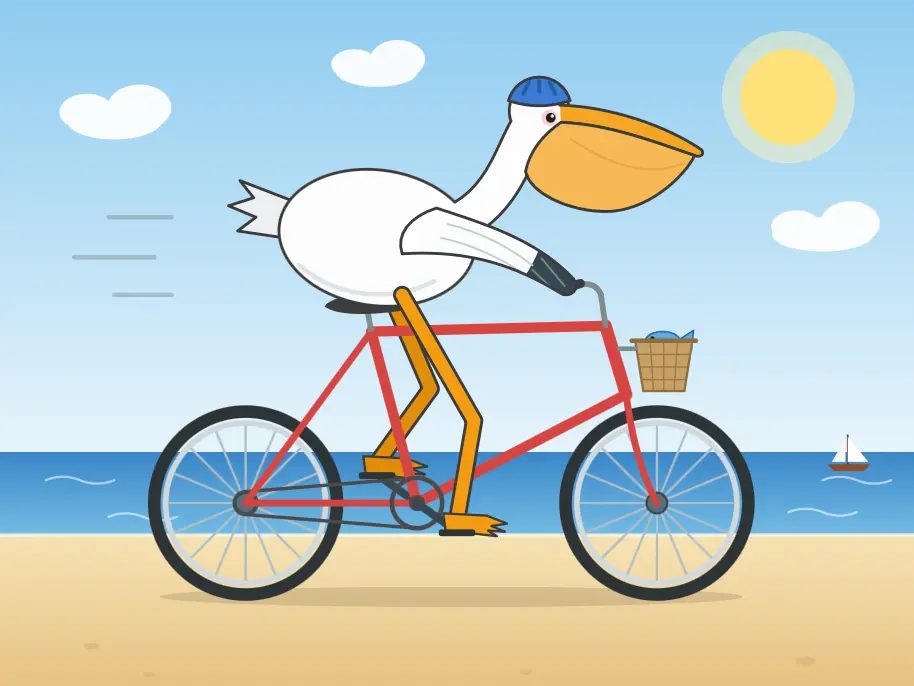 Anthropic lance Fable 5.1 et Mythos 5.1. Le communiqué insiste sur la recherche scientifique, avec un score de 52,6% sur le benchmark Terminal-Bench-Science 0.1, décrit comme « nouveau » 5. Le positionnement annoncé couvre le codage, le travail de connaissance et les tâches de résolution de problèmes sur longue durée 5.
⚡ 200+ kernels WebGPU signés Hugging Face
 Hugging Face publie
@huggingface/kernels, une collection de plus de 200 kernels WebGPU pour l’IA locale dans le navigateur 7. Aucun détail de performance ou de couverture de modèles n’est fourni dans le résumé, mais la quantité de kernels suggère une couverture large des opérations courantes.
📦 Codex embarque un runtime complet de 1,7GB
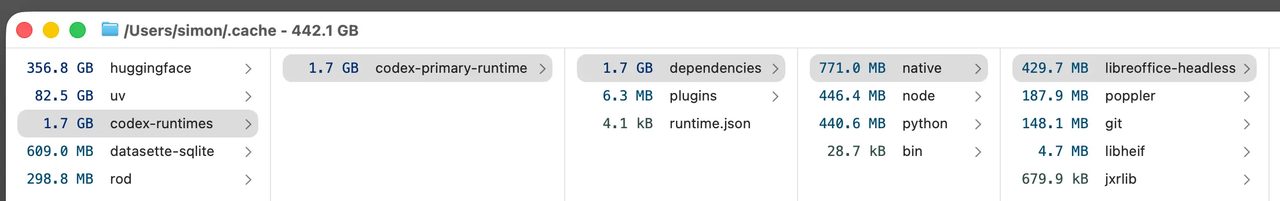 En inspectant
~/.cache/, Simon Willison découvre que l’application desktop Codex (rebaptisée ChatGPT) contient un dossier codex-primary-runtime de 1,7GB avec une installation Python complète, une installation Node.js complète, et des binaires natifs 13. L’agent embarque donc tout l’environnement d’exécution nécessaire, sans dépendre des runtimes système.
À retenir
Tuto du jour
Tuto / Outil : @huggingface/kernels 7 Ce qu’on installe : 200+ kernels WebGPU pour exécuter des modèles d’IA localement dans le navigateur. Prérequis hardware & commande : GPU compatible WebGPU ; installation via le package npm @huggingface/kernels 7.
Matos & Infra local
Sujet Matos/Infra : WebGPU Kernels pour IA locale — Hugging Face 7 Constat technique : Publication de 200+ kernels WebGPU pour l’inférence locale dans le navigateur, ciblant les GPU grand public sans dépendance CUDA. Recommandation dev : Évaluer ces kernels pour des prototypes d’inférence quantifiée sur GPU intégrés ou Mac M-series. Sujet Matos/Infra : Runtime Codex — Simon Willison 13 Constat technique : Le runtime local de l’app Codex occupe 1.7 Go, incluant Python, Node.js et binaires natifs. Recommandation dev : Anticiper ce poids disque pour les postes de dev équipés d’agents codants.
Fine-Tuning & Quantiz
Technique / Outil : Linear Reusable Neural Bases Architecture (LRNBA) 11 Apport : Réduction de la mémoire en phase d’entraînement et d’inférence via une meilleure efficacité paramétrique 11. Impact pratique : Framework de compression réseau pour atténuer le goulot d’étranglement mémoire des grands modèles 11. Pas de nouveauté fine-tuning ou quantification aujourd’hui.
RAG & Agents Locaux
Architecture / Outil : datasette-mcp 0.2 2 Cas d’usage : Exécution locale de requêtes SQL sur des bases de données via un serveur MCP, avec sortie structurée en objets pour les modèles 2. Clé de voûte : La modification du format de sortie (
rowsen tableau d’objets) améliore la fiabilité des modèles faibles dans le mapping colonne-valeur 2.
Track Record
Ce qu’on disait le 2026-08-16 : « Z.ai publie GLM-5.3, “frontier coding” avec capacités cyber émergentes » [2026-08-16]2 Verdict aujourd’hui : En attente. Aucun élément du jour ne mentionne GLM-5.3 ou Z.ai. La trajectoire “frontier coding” reste crédible au vu des benchmarks récents sur les agents de codage 410, mais aucune preuve directe de tenue ou d’infirmation n’est disponible dans les sources actuelles.
Sources (18) — vérifiées le 02/09/2026 05:00 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 2 | datasette-mcp 0.2 | Simon Willison | 1 septembre 2026 |
| 4 | How Foundational Models Became Superhuman in Bash | Phil Schmid | 1 septembre 2026 |
| 5 | Claude Fable 5.1 made me a really nice animated pelican | Simon Willison | 1 septembre 2026 |
| 7 | Introducing @huggingface/kernels: 200+ WebGPU Kernels for Local AI | Hugging Face | 1 septembre 2026 |
| 10 | CordisBench: Can Language Models Reason About Component Lifecycles in Dynamic Agent Harnesses? | arXiv | 1 septembre 2026 |
| 11 | A Mathematical Theory of Reusable Neural Bases for Network Compression | arXiv | 1 septembre 2026 |
| 13 | Codex bundles LibreOffice | Simon Willison | 1 septembre 2026 |
Autres lectures (11)
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | GeoJSON Map Viewer | Simon Willison | 1 septembre 2026 |
| 3 | Introducing wrapture | Simon Willison | 31 août 2026 |
| 6 | I trained a small transformer in 1.5hrs and it beats many LLMs | Hacker News | 1 septembre 2026 |
| 8 | UI-Venus-2 Technical Report | HF Papers | |
| 9 | GUI-CC: Benchmarking Contextual Consistency of GUI World Models as Agent Environments | HF Papers | |
| 12 | BenchMIRT: What are LLM benchmarks actually measuring? | Hugging Face | 1 septembre 2026 |
| 14 | Introducing agentic video understanding with Gemini | Google DeepMind | 1 septembre 2026 |
| 15 | Quoting Tarn Adams | Simon Willison | 1 septembre 2026 |
| 16 | Python 3.15.0 candidate 2 is here! | Simon Willison | 1 septembre 2026 |
| 17 | Quoting Andrew Digby | Simon Willison | 31 août 2026 |
| 18 | Harness-of-Harness: Multi-Day Autonomous Software Development with Continual Improvement | HF Papers |
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.