TL;DR
- Anthropic passe de 47 à 65 Md$ de revenus annualisés entre mai et juillet, mais son meilleur modèle peine à attirer les utilisateurs 8
- llm 0.33 migre vers OpenAI Python 3.x et remplace httpx par httpx2 11
- QuoteBench mesure les échecs de commandes Bash masqués par les scores de correspondance, 56 tâches en validation d’état final 15
Les 3 signaux
💰 Le paradoxe Anthropic
revenus en hausse, adoption en berne
 Les revenus annualisés d’Anthropic atteignent 65 Md$ en juillet, contre 47 Md$ en mai 8. Pendant ce temps, son modèle phare « struggle to attract users » face à des outils moins chers 8. Drew Breunig explique le mécanisme : avant Fable, améliorer son harness ou sa stratégie de contexte semblait inutile car un nouveau modèle arrivait au même prix et corrigeait les défauts. Fable a changé la donne : « la facture était si élevée et Opus était suffisant » 9. Le coût d’inférence pousse désormais les équipes à optimiser leur code au lieu d’attendre le prochain modèle.
🛠️ L’ingénierie de harness devient un sujet de recherche à part entière
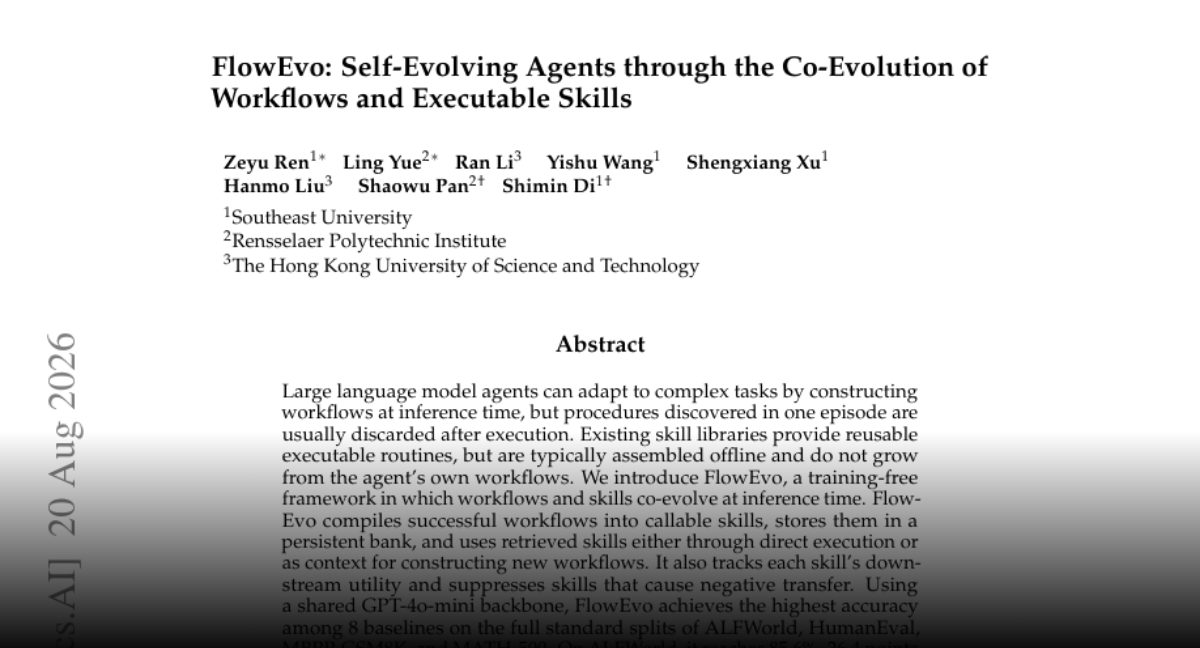 Trois papiers convergent sur l’évolution des harness d’agents. FlowEvo propose des agents qui co-évoluent workflows et compétences exécutables au fil des épisodes, au lieu de jeter les procédures découvertes 14. Le framework « Hierarchical Self-Improvement » traite le harness comme un artefact évolutif et spécifique à chaque tâche, plutôt que fixé après déploiement 16. AgentMercury synthétise des environnements vérifiables pour entraîner des agents sur des workflows métiers réalistes à l’échelle 3. Le papier « Graph Engineering » formalise la progression : Prompt Engineering, Context Engineering, Harness Engineering, et au-delà 12.
🐛 Les benchmarks cachent les vrais échecs des agents
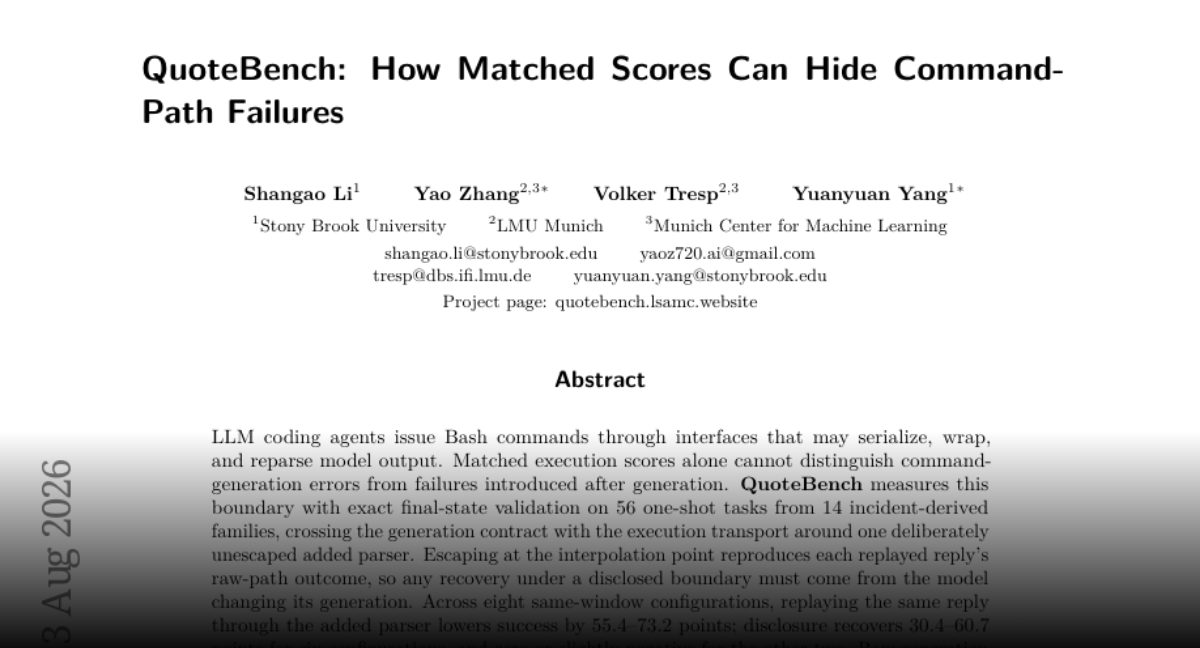 QuoteBench démontre que les scores de correspondance ne distinguent pas les erreurs de génération de commandes des échecs introduits par l’interface qui sérialise, wrappe et reparse la sortie du modèle 15. Sur 56 tâches one-shot, la validation d’état final révèle cette frontière 15. Parallèlement, l’étude sur le raisonnement en langue faiblement dotée montre que les benchmarks de précision sont du bruit à cette échelle : changer la graine aléatoire déplace le score de 7,7 points 5. Linus Torvalds raconte une session de debug « de l’enfer » où l’IA a énormément aidé, mais a plusieurs fois affirmé que le problème était insoluble — « je soupçonne que ces choses ont été entraînées par des gens qui… » 10.
À retenir
- 65Md$ — revenus annualisés d’Anthropic en juillet, contre 47 Md$ en mai, malgré une adoption difficile du modèle premium 8
- 7,7points — variation de score sur les benchmarks de précision en changeant uniquement la graine aléatoire, rendant les résultats non significatifs 5
- 56tâches — taille de QuoteBench pour mesurer les échecs de command-path avec validation d’état final exacte 15
Tuto du jour
Tuto / Outil : llm 0.33 11 Ce qu’on installe : Mise à jour de l’outil en ligne de commande
llm(interface pour modèles locaux/API). Prérequis hardware & commande : Non spécifié ; mise à niveau via le gestionnaire de paquets Python (pipx/pip) après la sortie de la 0.32.1 11.
Matos & Infra local
Sujet Matos/Infra : Quantification 2,7 bits pour VLMs mobiles — Llama-Mobile 13 Constat technique : Framework de quantification de VLMs pour matériel contraint, combinant pipeline de quantification et données d’entraînement générées par le modèle lui-même 13. Recommandation dev : Évaluer cette approche pour réduire l’empreinte mémoire des VLMs sur cible mobile.
Fine-Tuning & Quantiz
Technique / Outil : Llama-Mobile, quantification 2,7 bits de VLMs 13 Apport : réduction mémoire et calcul pour déploiement sur appareils contraints 13 Impact pratique : pipeline de quantification utilisant le modèle pour générer les données d’entraînement 13
Technique / Outil : Fine-tuning SFT vs RL sur langage faiblement doté 5 Apport : SFT ne modifie pas la précision ; RL corrige des comportements invisibles aux benchmarks 5 Impact pratique : les métriques de précision sont bruitées (7,7 points selon la seed) et insuffisantes 5
RAG & Agents Locaux
Architecture / Outil : llm 0.33 11 Cas d’usage : Exécution locale d’embeddings et de modèles via CLI, avec support de clés API pour
llm embed11. Clé de voûte : Mise à jour vers la bibliothèque OpenAI 3.x et httpx2 pour fiabiliser les appels locaux 11.
Track Record
Partiellement tenu
Ce qu’on disait le 2026-08-09 : « Les humains ratent 1 menace sur 3 en validant les commandes d’agents IA sur 40 000 parties » 3 Verdict aujourd’hui : partiellement tenu. La difficulté de validation humaine est confirmée par Simon Willison : la compétence clé est de « vérifier en toute confiance » les changements des agents, pas seulement tout relire 2. QuoteBench renforce ce point : les scores de correspondance masquent les échecs de chemins de commandes 15. Le taux de 1/3 n’est pas re-testé aujourd’hui.
Sources (18) — vérifiées le 24/08/2026 05:00 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 2 | More than just code review | Simon Willison | 22 août 2026 |
| 3 | AgentMercury: Your Agent Can Synthesize Verifiable Environments for Business Scenarios at scale | HF Papers | |
| 5 | Thinking in a Low-Resource Language: What SFT Builds, What RL Fixes, What Accuracy Cannot See | HF Papers | |
| 8 | Anthropic’s best AI model struggles to attract users as cheaper tools thrive | Simon Willison | 23 août 2026 |
| 9 | Quoting Drew Breunig | Simon Willison | 23 août 2026 |
| 10 | Quoting Linus Torvalds | Simon Willison | 22 août 2026 |
| 11 | llm 0.33 | Simon Willison | 22 août 2026 |
| 12 | Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence | HF Papers | |
| 13 | Llama-Mobile: Efficient 2.7-Bit Quantization of VLMs | HF Papers | |
| 14 | FlowEvo: Self-Evolving Agents through the Co-Evolution of Workflows and Executable Skills | HF Papers | |
| 15 | QuoteBench: How Matched Scores Can Hide Command-Path Failures | HF Papers | |
| 16 | Hierarchical Self-Improvement: A Framework for Task-Specific Evolvable Agent Harnesses | HF Papers |
Autres lectures (6)
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | Why your local LLM feels dumber than it is | Hacker News | 22 août 2026 |
| 4 | Beyond Correctness: Benchmarking and Aligning Response Behaviors in Hybrid-Thinking MLLMs | HF Papers | |
| 6 | Munder Difflin – Agent harness to run an office of your clones | Hacker News | 22 août 2026 |
| 7 | Re$^3$Cap: Retrieval-Guided Refinement for Image Captioning Enhancement via Reinforcement Learning | arXiv | 21 août 2026 |
| 17 | Mining beyond Earth with Space Robots: Exploration, Sampling, and Extraction | arXiv | 21 août 2026 |
| 18 | ViTacPhys: Physical Property-Aware Grasping from Human Visual-Tactile Demonstrations | arXiv | 21 août 2026 |
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.