TL;DR
Les 3 signaux
🔧 Outillage CLI
compatibilité et nouvelles capacités
 Simon Willison publie llm-openrouter 0.7, désormais compatible avec LLM 0.32. Le plugin affiche les traces de raisonnement des modèles OpenRouter et utilise leur implémentation de l’API Responses. Trois nouveaux outils côté serveur : Shell, WebFetch et WebSearch 3. Parallèlement, LLM 0.32.1 corrige un bug critique : les installations fraîches échouaient car la lib OpenAI a retiré httpx, et LLM en dépendait via une dépendance transitive. Le correctif épingle openai<3 12.
⚡ Performance inférence
3,2× plus rapide
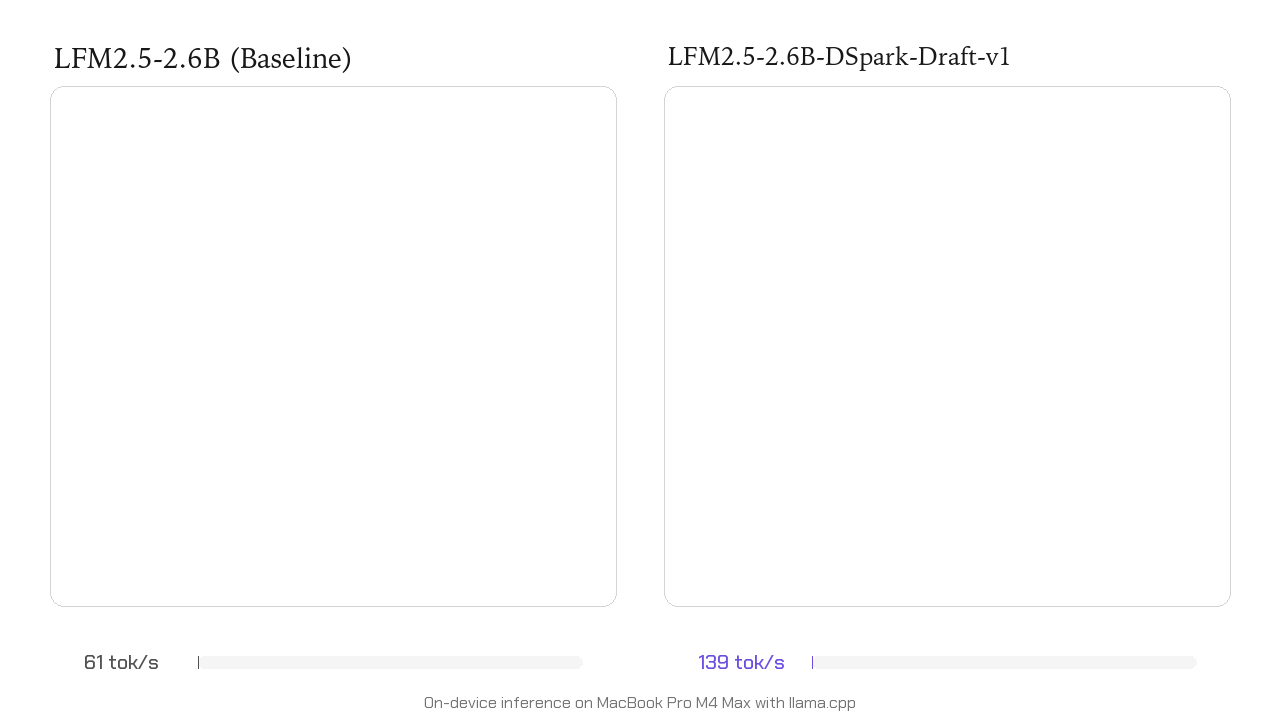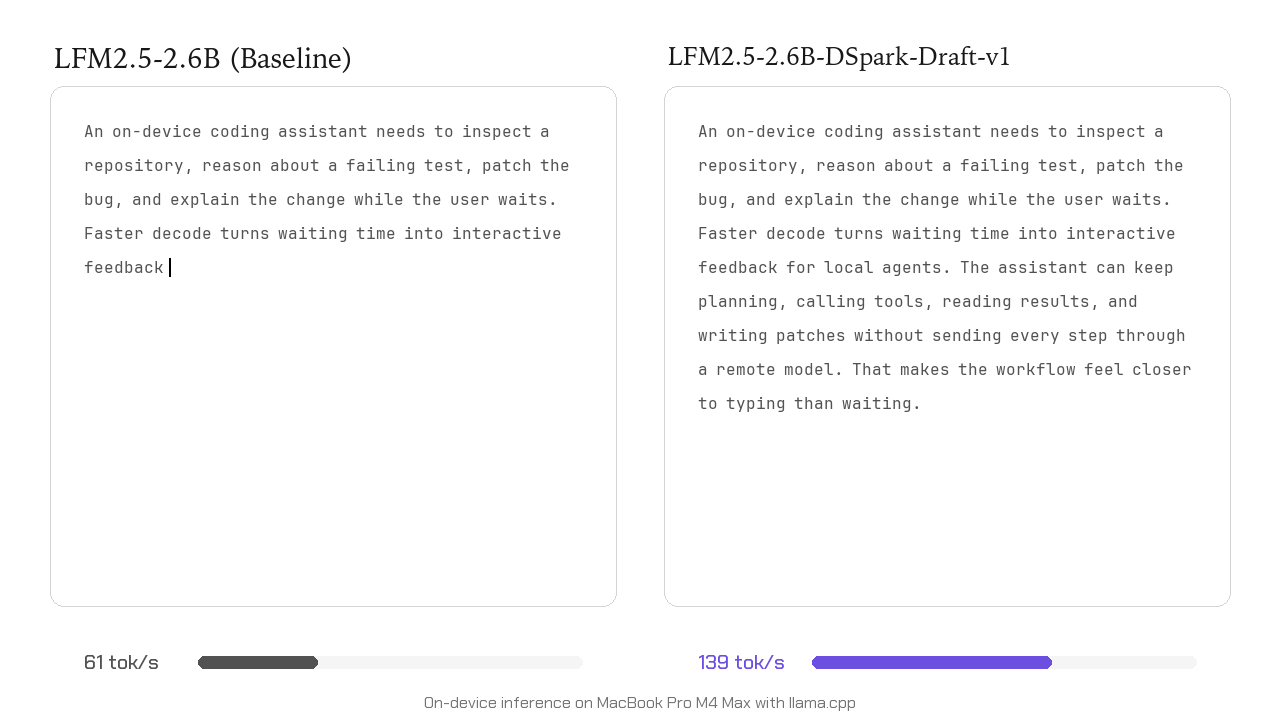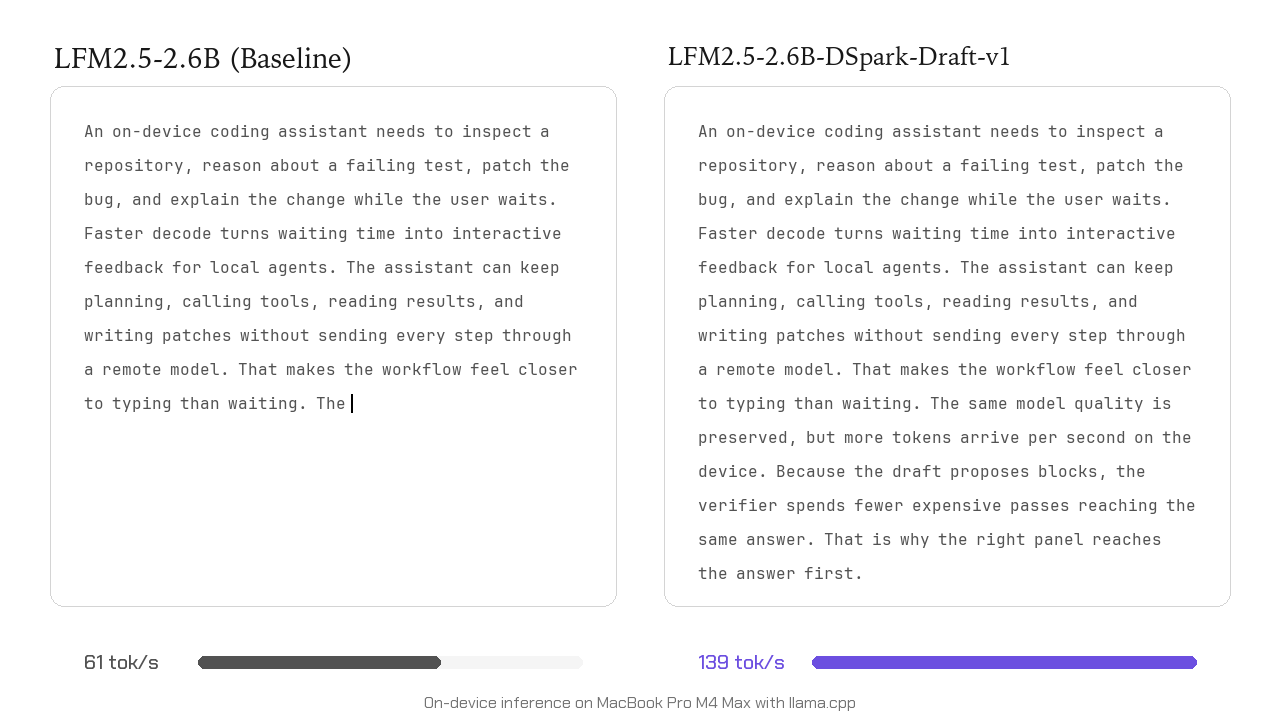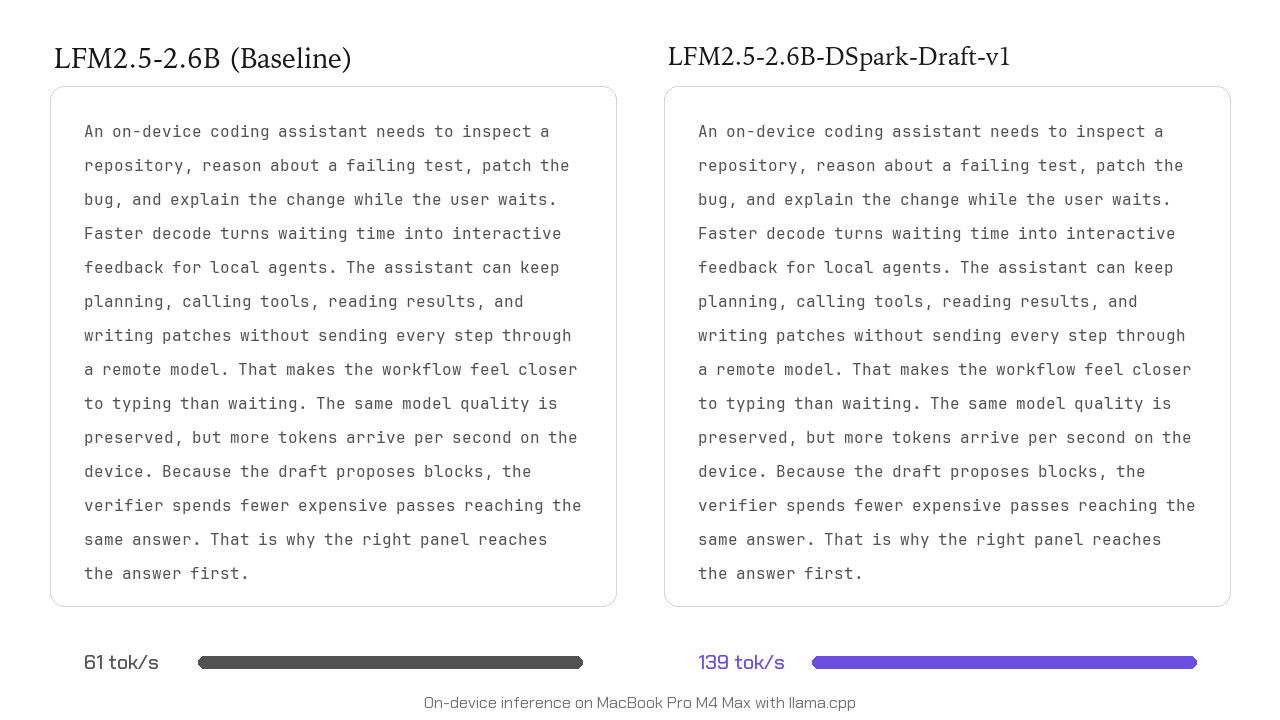 Liquid AI publie LFM2.5-DSpark, annonçant jusqu’à 3,2× d’accélération de l’inférence 4. Aucun détail technique supplémentaire fourni dans la source.
🖥️ Exécution locale
cache KV sur SSD et WebView
 oMLX écrit le cache KV des modèles sur le SSD au lieu de la mémoire. Reprendre une session ne recalcule plus le contexte complet. Le cache est actif par défaut et vise 10 % du disque 5. Côté navigateur, Bun 1.4 introduit Bun.WebView, permettant une API JSON type shot-scraper 16.
À retenir
Tuto du jour
Tuto / Outil : oMLX – serveur LLM local sur Mac Apple Silicon 5 Ce qu’on installe : Un serveur d’agents IA en local qui écrit le cache KV des modèles sur le SSD au lieu de la mémoire. Prérequis hardware & commande : Mac Apple Silicon ; cache actif d’office visant 10 % du disque. Aucune commande listée dans la source.
Matos & Infra local
Sujet Matos/Infra : oMLX pour Mac Apple Silicon 5 Constat technique : Le cache KV est écrit sur SSD au lieu de la RAM, évitant le recalcul complet du contexte à la reprise d’une session ; le cache occupe par défaut 10 % du disque 5. Recommandation dev : Activer oMLX pour les sessions longues sur Mac M-series afin de réduire la charge mémoire, en surveillant l’espace disque alloué 5. Sujet Matos/Infra : Inférence accélérée LFM2.5-DSpark 4 Constat technique : Le modèle revendique une inférence jusqu’à 3,2 fois plus rapide 4. Recommandation dev : Évaluer ce gain de vitesse pour les déploiements d’inférence locale quantifiée 4.
Fine-Tuning & Quantiz
Technique / Outil : oMLX – cache KV sur SSD 5 Apport : évite le recalcul complet du contexte lors de la reprise d’une session, en échange de 10 % du disque 5. Impact pratique : le cache actif d’office réduit la latence de reprise sur Apple Silicon 5. Technique / Outil : Fine-tuning SFT vs RL en langue faiblement dotée 6 Apport : la précision ne change pas ; le seed seul déplace le score de 7,7 points 6. Impact pratique : l’évaluation par benchmark est non fiable à cette échelle 6.
RAG & Agents Locaux
Architecture / Outil : oMLX 5 Cas d’usage : Exécution d’agents IA en local sur Mac Apple Silicon, avec persistance du cache KV sur SSD pour éviter le recalcul complet du contexte lors de la reprise d’une session 5. Clé de voûte : Stratégie de cache disque (10 % du volume) remplaçant la mémoire vive pour la reprise de session 5.
Track Record
Partiellement tenu
Ce qu’on disait le 2026-08-06 : Liquid AI déploie LFM2.5-2.6B pour agents locaux 3 Verdict aujourd’hui : partiellement tenu. Liquid AI publie LFM2.5-DSpark, avec une inférence jusqu’à 3,2x plus rapide 4. Le déploiement local est conforté par oMLX, qui optimise le cache KV sur SSD pour les Mac Apple Silicon 5. La promesse initiale d’agents locaux se matérialise, mais via un nouveau modèle, pas le 2.6B initialement cité.
Sources (18) — vérifiées le 22/08/2026 05:00 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 3 | llm-openrouter 0.7 | Simon Willison | 21 août 2026 |
| 4 | Up to 3.2x Faster Inference with LFM2.5-DSpark | Hugging Face | 20 août 2026 |
| 5 | oMLX – Faites tourner vos agents IA en local sur votre Mac | Korben | 20 août 2026 |
| 6 | Thinking in a Low-Resource Language: What SFT Builds, What RL Fixes, What Accuracy Cannot See | HF Papers | |
| 12 | llm 0.32.1 | Simon Willison | 21 août 2026 |
| 16 | A shot-scraper-style JSON API on Bun 1.4’s new Bun.WebView | Simon Willison | 20 août 2026 |
Autres lectures (12)
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | Stop Making TUIs | Simon Willison | 21 août 2026 |
| 2 | Recursive Self-Improvement | Phil Schmid | 21 août 2026 |
| 7 | NARU: A Benchmark for NARrative Evolution and Cultural Nuance Understanding in Japanese Extreme Long Video | HF Papers | |
| 8 | Repo0: Design-Driven Zero-to-All Code Generation | HF Papers | |
| 9 | AI4AI-Bench: Benchmarking LLM Agents in Algorithmic Design for Recursive Self-Improvement | arXiv | 20 août 2026 |
| 10 | Pandora’s AI Model Routing Box: Efficient Allocation with Costly Value Estimation | arXiv | 20 août 2026 |
| 11 | MidTool: Mid-training Data Synthesis for Agentic Tool Use | arXiv | 20 août 2026 |
| 13 | Quoting Matt Webb | Simon Willison | 21 août 2026 |
| 14 | Measuring benchmark optimization in speech recognition | Hugging Face | 21 août 2026 |
| 15 | ChatGPT search now uses the site:operator at scale | Simon Willison | 20 août 2026 |
| 17 | FlowEvo: Self-Evolving Agents through the Co-Evolution of Workflows and Executable Skills | HF Papers | |
| 18 | QuoteBench: How Matched Scores Can Hide Command-Path Failures | HF Papers |
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.