TL;DR
Les 3 signaux
⚡ Inférence — Liquid AI publie LFM2.5-DSpark avec des gains d’inférence jusqu’à 3,2× 2. Les détails techniques restent sur Hugging Face, mais l’ordre de grandeur est net pour qui cherche à réduire la latence ou les coûts de serving.
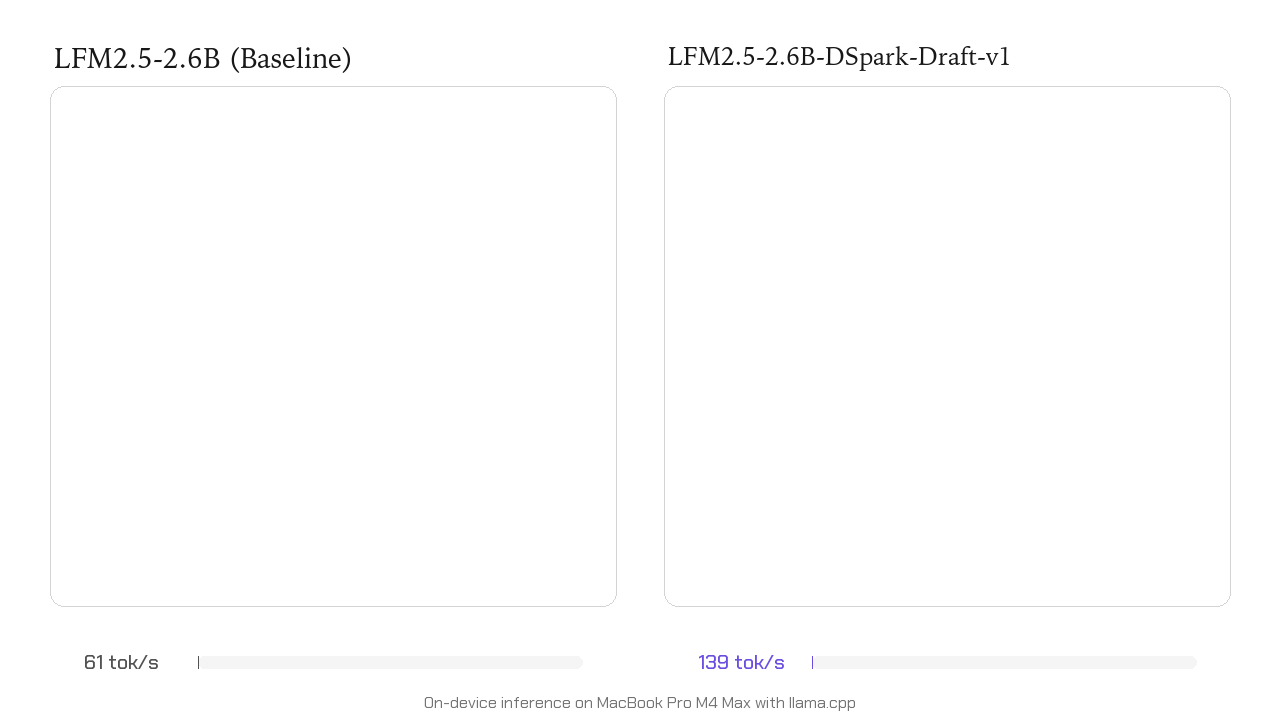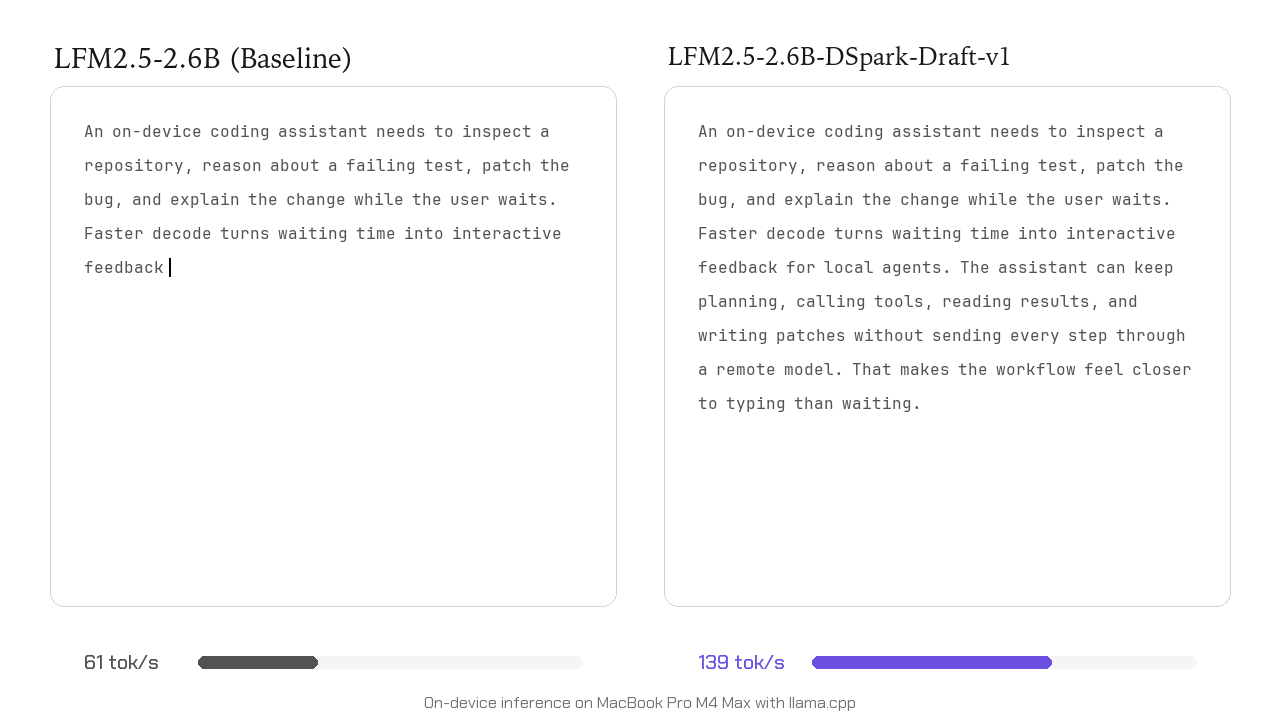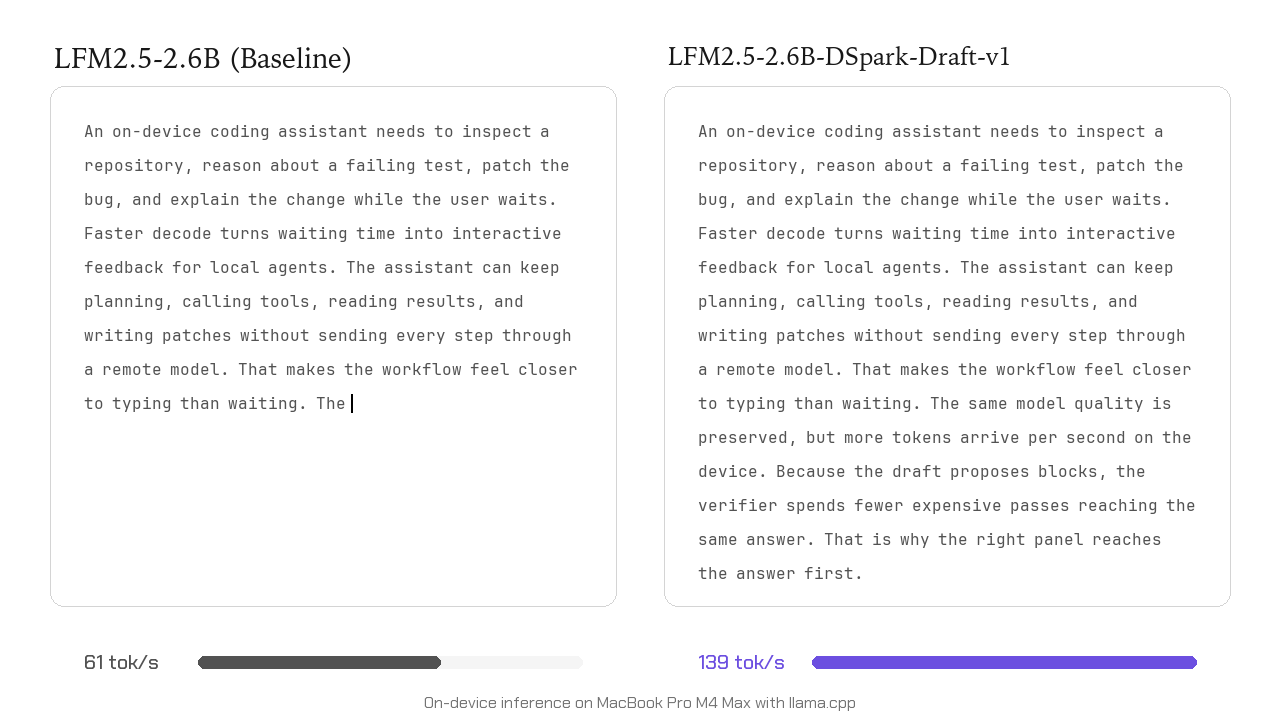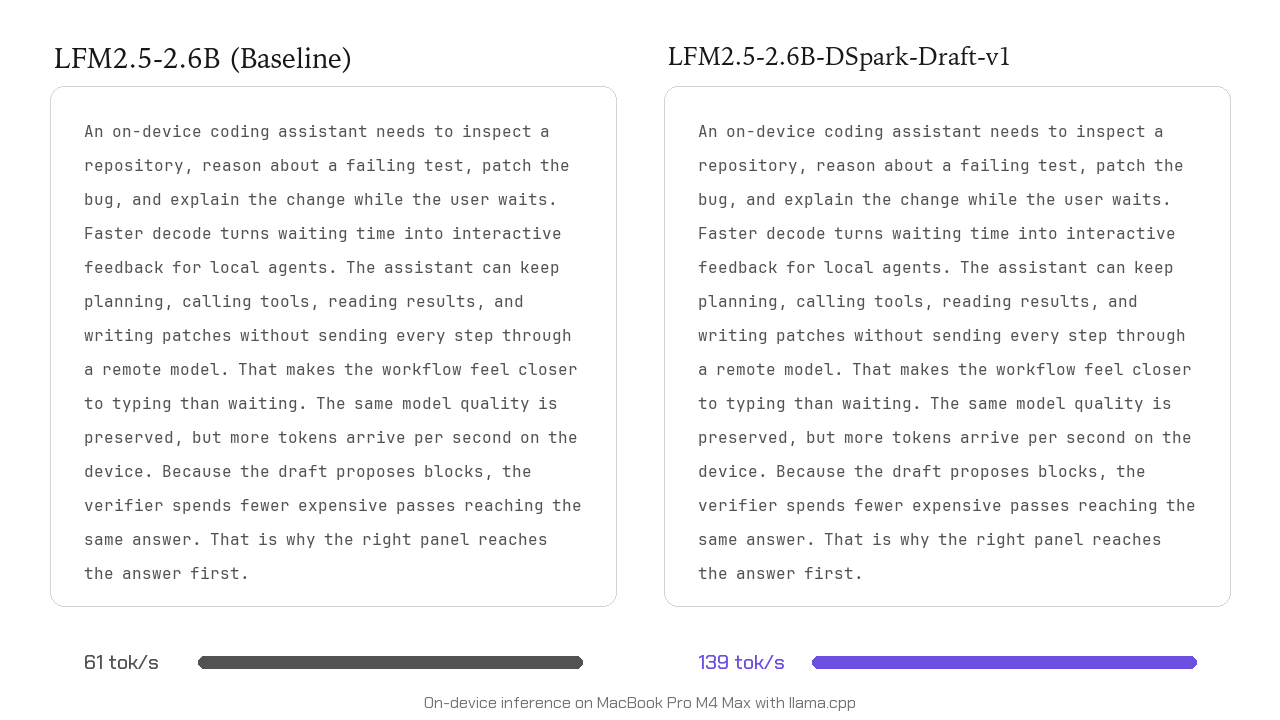
Pourquoi ça compte : 3,2× de débit en plus sur le même hardware, soit une baisse directe de la facture d’inférence ou une montée en charge sans ajout de GPU.
🖥️ Runtime — Bun 1.4 sort en version stable, la première depuis le rewrite Rust 11. La release introduit Bun.WebView, et Simon Willison a déjà testé une API JSON style shot-scraper dessus 11. Le rewrite Rust est minimisé dans les notes de version, mais le runtime est reparti sur une base neuve.
Pourquoi ça compte : Bun.WebView ouvre une voie pour exposer des APIs JSON depuis une WebView embarquée, sans serveur séparé — un pattern utile pour des outils locaux légers.
💾 Cache local — oMLX écrit le cache KV des modèles sur le SSD au lieu de le garder en mémoire, ce qui évite le recalcul complet du contexte à la reprise d’une session 3. Le cache est actif par défaut et vise 10 % de l’espace disque 3.
Pourquoi ça compte : les sessions longues sur Apple Silicon reprennent instantanément sans repasser par le calcul du contexte, au prix d’un usage disque borné à 10 %.
À retenir
Tuto du jour
Tuto / Outil : oMLX – serveur LLM local sur Mac Apple Silicon 3 Ce qu’on installe : Un serveur LLM local qui écrit le cache KV des modèles sur SSD au lieu de la RAM. Prérequis hardware & commande : Mac Apple Silicon ; cache actif d’office, visant 10 % du disque.
Matos & Infra local
Sujet Matos/Infra : oMLX – agents IA locaux sur Mac Apple Silicon 3 Constat technique : Le cache KV est écrit sur le SSD au lieu de la RAM, évitant un recalcul complet du contexte à la reprise d’une session ; le cache consomme par défaut 10 % du disque. Recommandation dev : Pour les sessions longues sur Mac, activez cette option afin de réduire la latence de reprise, en surveillant l’espace disque alloué.
Fine-Tuning & Quantiz
Technique / Outil : oMLX – cache KV sur SSD pour LLM local 3 Apport : écrit le cache KV sur SSD au lieu de la RAM ; reprendre une session évite le recalcul complet du contexte 3 Impact pratique : Active le cache par défaut, visant 10 % de l’espace disque, au prix d’une latence accrue 3 Technique / Outil : MidTool – synthèse de données pour mid-training agentique 9 Apport : renforce les capacités agentiques via un mid-training ciblé sur l’usage d’outils 9 Impact pratique : applicable aux contextes d’ingénierie logicielle pour améliorer les compétences de raisonnement 9
RAG & Agents Locaux
Architecture / Outil : oMLX 3 Cas d’usage : Exécution d’agents IA en local sur Mac Apple Silicon, avec reprise de session sans recalcul complet du contexte 3. Clé de voûte : Cache KV écrit sur SSD (10 % du disque) au lieu de la RAM, activé par défaut 3.
Track Record
Partiellement tenu
Ce qu’on disait le 2026-08-06 : Liquid AI déploie LFM2.5-2.6B pour agents locaux 3 Verdict aujourd’hui : partiellement tenu. Liquid AI confirme la dynamique avec LFM2.5-DSpark, annonçant une inférence jusqu’à 3,2x plus rapide 2. Le déploiement local est renforcé par l’arrivée d’oMLX, qui optimise le cache KV sur SSD pour les Mac Apple Silicon 3. La promesse initiale d’agents locaux efficaces se concrétise via ces deux avancées.
Sources (18) — vérifiées le 21/08/2026 05:01 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 2 | Up to 3.2x Faster Inference with LFM2.5-DSpark | Hugging Face | 20 août 2026 |
| 3 | oMLX – Faites tourner vos agents IA en local sur votre Mac | Korben | 20 août 2026 |
| 9 | MidTool: Mid-training Data Synthesis for Agentic Tool Use | arXiv | 20 août 2026 |
| 11 | A shot-scraper-style JSON API on Bun 1.4’s new Bun.WebView | Simon Willison | 20 août 2026 |
Autres lectures (14)
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.