TL;DR
Les 3 signaux
🤖 Gemini Robotics 2
l’intelligence corps entier
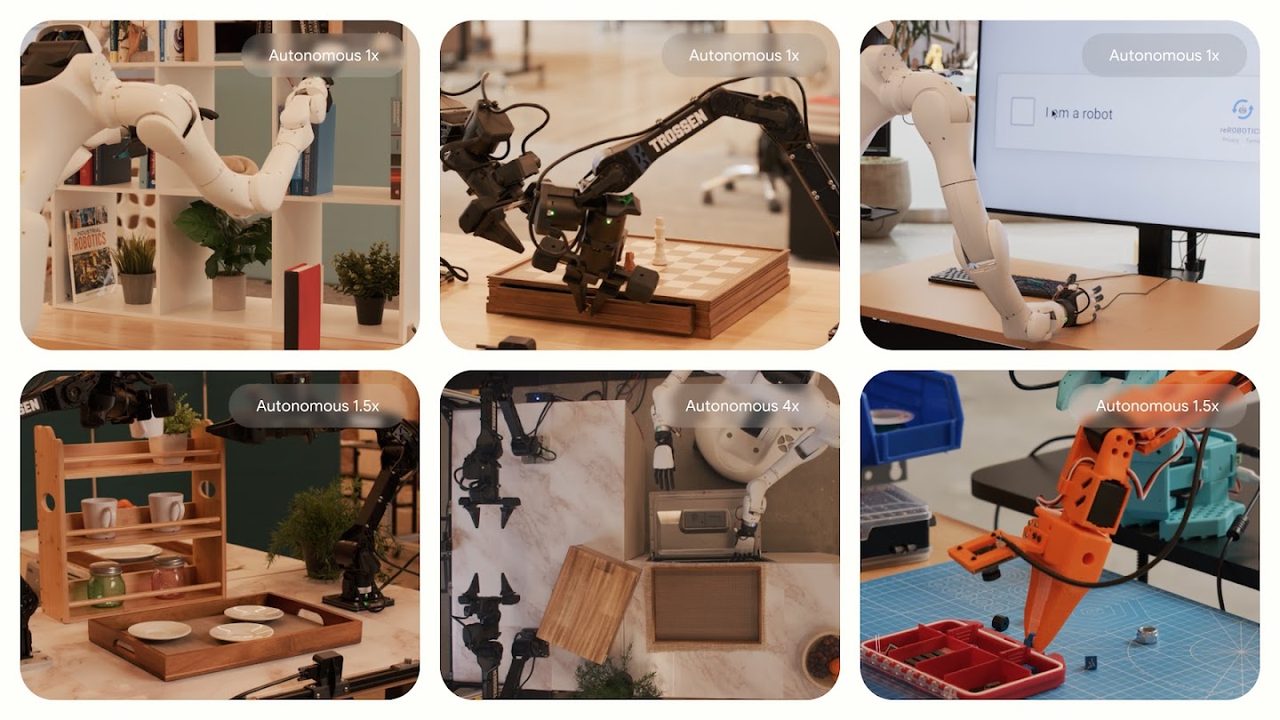 DeepMind lance Gemini Robotics 2, orienté « whole body intelligence » pour les robots 2. Le même jour, Gemini Robotics ER 2 apporte la compréhension vidéo, l’orchestration de tâches et la collaboration multi-robots 5. Les deux modèles ciblent le raisonnement sur des tâches du monde réel.
⚡ DeepSeek V4 Flash 0731
analyse prix/performance
 Artificial Analysis publie une analyse détaillée du modèle DeepSeek V4 Flash 0731, couvrant intelligence, performance et prix 3. Le modèle est discuté à 540 points sur Hacker News avec 293 commentaires 3.
🩺 ORCA-bench
benchmark pour agents oncall
 ORCA-bench évalue la préparation des agents LLM pour le oncall : raisonnement sur métriques bruitées, logs, traces et code source, à partir de rapports utilisateurs ambigus, souvent des heures après le début de l’incident 12. Le benchmark cible le root cause analysis, distinct de l’écriture de code 12.
À retenir
Radar Contradictions
Claim : Gemini Robotics 2 apporte une « whole body intelligence » aux robots, présenté comme un progrès majeur 2. Contre-signal : Le papier See2Think montre que les modèles multimodaux n’utilisent pas réellement les états visuels intermédiaires (sketches, annotations) lors du raisonnement, remettant en cause la fiabilité des capacités de perception annoncées pour la robotique 15. Ce que ça change pour un dev : Ne pas présumer que les capacités de raisonnement visuel de Gemini Robotics 2 sont effectives sans validation sur des tâches ciblées.
Reproduit en 15 min
Repo/Snippet : [qm – Multiplayer agent harness for work 1] Comment tester : Clonez le dépôt, lancez le harness avec deux agents locaux sur une tâche de type “todo list”, observez la coordination via les logs. Vérifiez la gestion des rôles dans le README. Prérequis : Python 3.10+, aucune API key requise pour le mode local.
Track Record
Partiellement tenu
Ce qu’on disait le 2026-07-08 : GLM 5.2 atteint des coûts d’inférence 10× inférieurs aux modèles propriétaires, signalant un effondrement des marges IA 1. Verdict aujourd’hui : partiellement tenu. La pression prix persiste : DeepSeek V4 Flash fait l’objet d’une analyse dédiée “Intelligence, Performance and Price” 3, et la gestion des GPU idle est présentée comme un enjeu majeur de coûts 13. Aucune donnée chiffrée ne confirme l’effondrement des marges.
Sous le radar
L’item : PAIChecker: Uncovering and Checking PR-Issue Misalignment in SWE-Bench-Like Benchmarks 7 (arXiv, faible: non coté) Pourquoi c’est du signal : Attaque la validité structurelle des benchmarks SWE-bench, fondation de l’évaluation des agents. Un correctif méthodologique discret mais critique pour la fiabilité des mesures.
Donnée manquante
L’annonce : DeepSeek V4 Flash 0731 – analyse de performance et de prix 3 Ce qui manque : Le coût d’inférence précis par token (entrée/sortie) et la taille du dataset d’entraînement ne sont pas divulgués dans l’analyse. Pourquoi ça compte : Sans ces données, l’évaluation du rapport performance/prix est incomplète, et la comparaison avec les modèles concurrents ne peut pas être reproduite indépendamment.
Sources (18) — vérifiées le 01/08/2026 05:00 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | qm – Multiplayer agent harness for work | Hacker News | 31 juillet 2026 |
| 2 | Gemini Robotics 2 brings whole body intelligence to robots | Hacker News | 30 juillet 2026 |
| 3 | DeepSeek V4 Flash 0731 Intelligence, Performance and Price Analysis | Hacker News | 31 juillet 2026 |
| 5 | Gemini Robotics ER 2: powering robotics with video understanding, task orchestration, and multi-robot collaboration | Google DeepMind | 30 juillet 2026 |
| 7 | PAIChecker: Uncovering and Checking PR-Issue Misalignment in SWE-Bench-Like Benchmarks | arXiv | 30 juillet 2026 |
| 12 | ORCA-bench: How Ready Are Language Model Agents for Oncall? | arXiv | 30 juillet 2026 |
| 13 | GPU Management: Why Idle GPUs Are the New Grounded Aircraft | Hugging Face | 30 juillet 2026 |
| 15 | See2Think: Do Multimodal Models Really Use Intermediate Visual States? | HF Papers |
Autres lectures (10)
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.