TL;DR
- Google DeepMind publie Gemini Robotics 2 et ER 2, ajoutant la compréhension vidéo et la collaboration multi-robots 14
- Un moteur open-source fait tourner Gemma 4 26B dans 2 Go de RAM sur Mac M-series 2
- ORCA-bench évalue les agents LLM sur le diagnostic d’incidents oncall, un domaine non couvert par les benchmarks de code 13
Les 3 signaux
🤖 Gemini Robotics 2
le corps entier comme interface
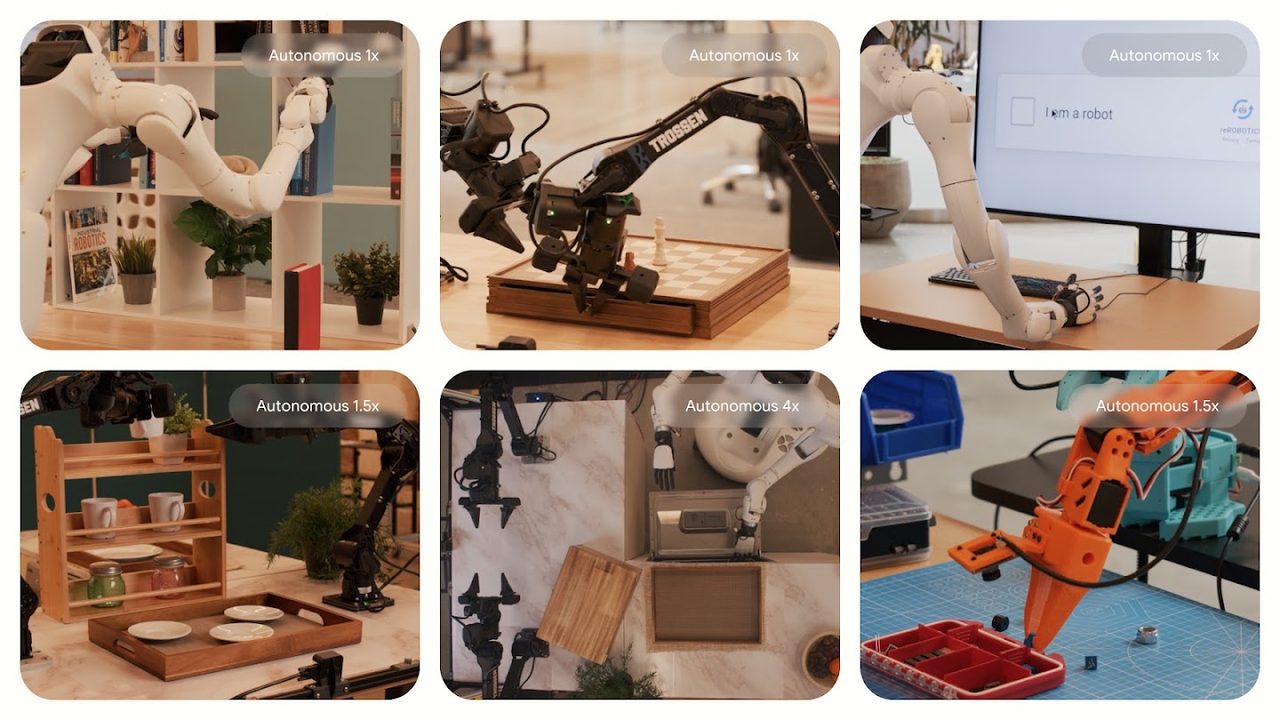 DeepMind publie Gemini Robotics 2, orienté « whole body intelligence » pour les robots 1. Le même jour, Gemini Robotics ER 2 ajoute la compréhension vidéo, l’orchestration de tâches et la collaboration multi-robots 4. Les deux modèles ciblent le raisonnement sur des tâches du monde réel, pas seulement la génération de mouvements.
💾 Gemma 4 26B dans 2 Go de RAM sur Mac
 Un moteur open-source nommé turbo-fieldfare exécute Gemma 4 26B dans 2 Go de RAM sur n’importe quel Mac M-series 2. Le projet est publié sur GitHub avec 886 points HN. Aucun détail technique n’est fourni sur la méthode de compression ou la vitesse d’inférence.
🚨 ORCA-bench
les agents LLM face à l’oncall
 ORCA-bench évalue les agents sur le diagnostic de cause racine : raisonner sur des métriques bruitées, logs, traces et code source à partir de rapports utilisateurs ambigus, souvent des heures après le début de l’incident 13. Le benchmark couvre un domaine distinct de l’écriture de code, de la recherche ou du patch.
À retenir
- 2Go de RAM — Gemma 4 26B tourne sur Mac M-series via un moteur open-source, turbo-fieldfare 2
- 2607.28545— ORCA-bench, nouveau benchmark pour le diagnostic oncall par agents LLM 13
- 1β=1 — l’OPSD vanille est un cas particulier d’une famille plus large de policy optimization ; sa fragilité a une cause structurelle 9
Radar Contradictions
Claim : Gemini Robotics 2 apporte une « whole body intelligence » aux robots 1. Contre-signal : Le billet 4 présente Gemini Robotics ER 2 comme une « step change » en compréhension vidéo et orchestration, mais ne fournit aucune métrique de performance ni benchmark comparatif pour étayer cette affirmation. Ce que ça change pour un dev : L’absence de données chiffrées rend impossible la validation des gains annoncés avant intégration.
Reproduit en 15 min
Repo/Snippet : turbo-fieldfare [2] Comment tester : 1. Clonez le repo. 2. Lancez le script d’installation fourni. 3. Exécutez l’inférence sur un prompt simple. Prérequis : Mac Apple Silicon (M-series), 2 GB RAM libre.
Track Record
Partiellement tenu
Ce qu’on disait le 2026-07-08 : « GLM 5.2 atteint 672 points HN, signale un effondrement des marges sur l’inférence IA » 1 Verdict aujourd’hui : Partiellement tenu. La pression sur les coûts d’inférence persiste, mais via l’optimisation matérielle et logicielle plutôt que par un effondrement des prix : un moteur open-source fait tourner Gemma 4 26B dans 2 Go de RAM sur Mac M-series 2, et un blog dédié compare les GPU inactifs à des avions cloués au sol, soulignant le gaspillage de capacité 14.
Sous le radar
L’item : PAIChecker 8 — arXiv, faible visibilité (aucun point HN, paper fraîche) Pourquoi c’est du signal : Identifie une faille structurelle dans la construction des benchmarks SWE-Bench-like (mésalignement PR-issue), ce qui invalide potentiellement des résultats publiés. Cible un problème de méthodologie d’évaluation, pas un simple gain de performance.
Donnée manquante
L’annonce : Gemini Robotics 2 apporte « whole body intelligence » aux robots 14 Ce qui manque : Le coût d’inférence par action ou par heure d’utilisation n’est pas divulgué. Pourquoi ça compte : Sans ce chiffre, impossible d’évaluer la viabilité économique réelle en remplacement des solutions existantes, ni de comparer la latence/coût aux contraintes matérielles des robots physiques.
Sources (18) — vérifiées le 31/07/2026 05:00 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | Gemini Robotics 2 brings whole body intelligence to robots | Hacker News | 30 juillet 2026 |
| 2 | Show HN: Open-source engine running Gemma 4 26B in 2 GB RAM on any M-series Mac | Hacker News | 29 juillet 2026 |
| 4 | Gemini Robotics ER 2: powering robotics with video understanding, task orchestration, and multi-robot collaboration | Google DeepMind | 30 juillet 2026 |
| 8 | PAIChecker: Uncovering and Checking PR-Issue Misalignment in SWE-Bench-Like Benchmarks | arXiv | 30 juillet 2026 |
| 9 | $β$-OPSD: Deriving with Policy Optimization, Training with Self-Distillation | arXiv | 30 juillet 2026 |
| 13 | ORCA-bench: How Ready Are Language Model Agents for Oncall? | arXiv | 30 juillet 2026 |
| 14 | GPU Management: Why Idle GPUs Are the New Grounded Aircraft | Hugging Face | 30 juillet 2026 |
Autres lectures (11)
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.