TL;DR
- Google annonce de nouvelles capacités dans Managed Agents dans l’API Gemini, dont le modèle 3.6 Flash et des hooks 3
- Allen AI publie la plateforme OlmoEarth sur Hugging Face pour l’inférence géospatiale à l’échelle planétaire 2
- Liquid AI publie LFM2.5-Encoders pour l’inférence long-contexte rapide sur CPU 4
Les 3 signaux
🤖 Agents managés Google
 Google annonce de nouvelles capacités dans Managed Agents dans l’API Gemini, dont le modèle 3.6 Flash et des hooks, afin que les développeurs puissent construire des agents fiables et prêts pour la production 3.
Pourquoi ça compte : Vous pouvez déployer des agents sans gérer l’infrastructure d’orchestration, avec un modèle 3.6 Flash et des hooks pour le contrôle de flux.
🌍 Inférence géospatiale à l’échelle planétaire
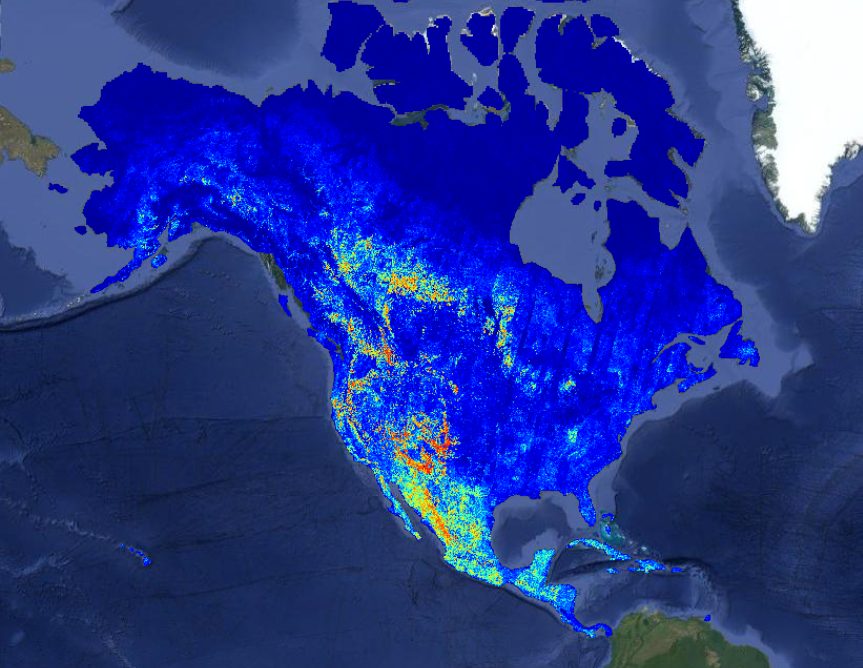 Allen AI publie la plateforme OlmoEarth sur Hugging Face, permettant l’inférence géospatiale à l’échelle planétaire 2.
Pourquoi ça compte : Vous pouvez exécuter des modèles de vision sur des datasets géospatiaux entiers sans gérer le partitionnement ou la parallélisation, avec une API unifiée sur Hugging Face.
⚡ Inférence long-contexte sur CPU
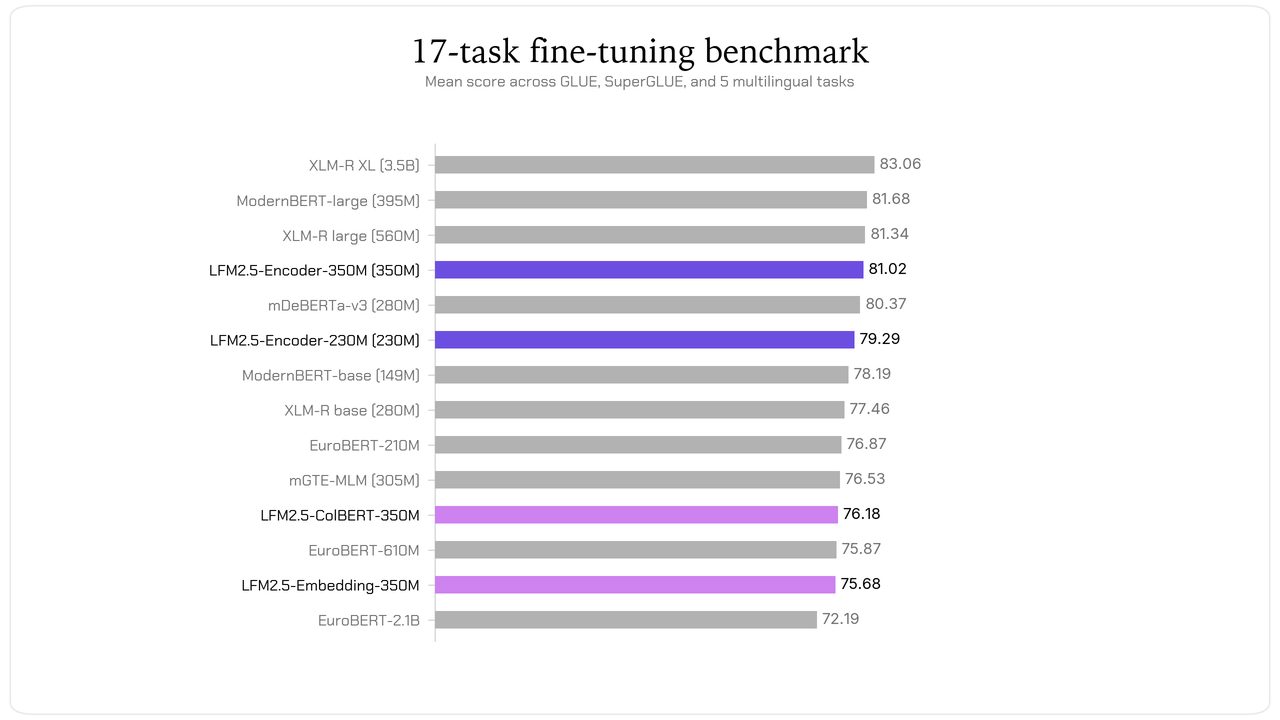 Liquid AI publie LFM2.5-Encoders, des encodeurs optimisés pour l’inférence long-contexte rapide sur CPU 4.
Pourquoi ça compte : Vous pouvez déployer des systèmes RAG ou de classification long-contexte sans GPU, réduisant les coûts d’infrastructure et permettant l’exécution sur edge ou serveurs CPU existants.
À retenir
Radar Contradictions
Claim : On-policy distillation (OPD) grounds token-level supervision in the student’s own trajectory 6. Contre-signal : Le même papier identifie un échec de préfixe : une fois que l’étudiant s’engage dans une direction erronée, les générations suivantes construisent sur cette déviation, produisant une supervision peu fiable 6. Ce que ça change pour un dev : L’implémentation d’OPD nécessite une gestion explicite des déviations de raisonnement pour éviter un gaspillage computationnel.
Reproduit en 15 min
Repo/Snippet : Benchmarking Opus 5 on SlopCodeBench 1 Comment tester : 1. Cloner le dépôt et ouvrir le notebook. 2. Exécuter les cellules de benchmark avec un modèle Opus 5. 3. Comparer le score au tableau de résultats. Prérequis : Python, clé API Anthropic.
Track Record
Partiellement tenu
Ce qu’on disait le 2026-07-08 : « GLM 5.2 atteint 672 points HN, signale un effondrement des marges sur l’inférence IA » 1 Verdict aujourd’hui : partiellement tenu. Aucun élément récent ne confirme un effondrement généralisé, mais la tendance à la baisse des coûts se poursuit : la migration vers GPT-5.6 affiche 27% de réduction 4 et GLM-5.2 sur AMD revendique un record de performance par dollar 2.
Sous le radar
L’item : arXiv 2607.26041v1 – Desktop-Delta Bench 8 (arXiv, 0 citations) Pourquoi c’est du signal : Isole une capacité rarement mesurée : la reconstruction des transitions GUI causales par un agent, distincte du succès final ou du grounding d’image unique. Le benchmark cible un goulot d’étranglement concret pour les agents desktop, sans bruit médiatique.
Donnée manquante
L’annonce : Benchmarking Opus 5 on SlopCodeBench 1 Ce qui manque : Les conditions exactes de benchmark (température, échantillons, seeds) et la taille du dataset ne sont pas divulguées, rendant la reproductibilité impossible. Pourquoi ça compte : Sans ces détails, les performances rapportées ne peuvent être vérifiées ni comparées à d’autres modèles dans des conditions équivalentes.
Sources (18) — vérifiées le 29/07/2026 05:00 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | Benchmarking Opus 5 on SlopCodeBench | Hacker News | 27 juillet 2026 |
| 2 | The OlmoEarth Platform: Geospatial inference at planetary scale | Hugging Face | 28 juillet 2026 |
| 3 | Gemini API Managed Agents: 3.6 Flash, hooks, and more | Google AI | 28 juillet 2026 |
| 4 | LFM2.5-Encoders for Fast Long-Context Inference on CPU | Hugging Face | 28 juillet 2026 |
| 6 | Pass the Baton: Trajectory-Relayed On-Policy Distillation | arXiv | 28 juillet 2026 |
| 8 | Desktop-Delta Bench: Do Computer-Use Models Understand Desktop GUI Transitions? | arXiv | 28 juillet 2026 |
Autres lectures (12)
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.