TL;DR
Les 3 signaux
⚡ Kimi K3 : un open-weight qui passe la barre des frontier models
 Kimi publie le modèle K3, atteignant 1681 points sur Hacker News 2. Le modèle est open-weight. La publication technique détaille les performances sur des benchmarks standards.
Pourquoi ça compte : alternative open-weight viable aux API propriétaires, avec des coûts d’inférence potentiellement réduits.
🔍 NVIDIA Nemotron 3 Embed domine le retrieval agentic
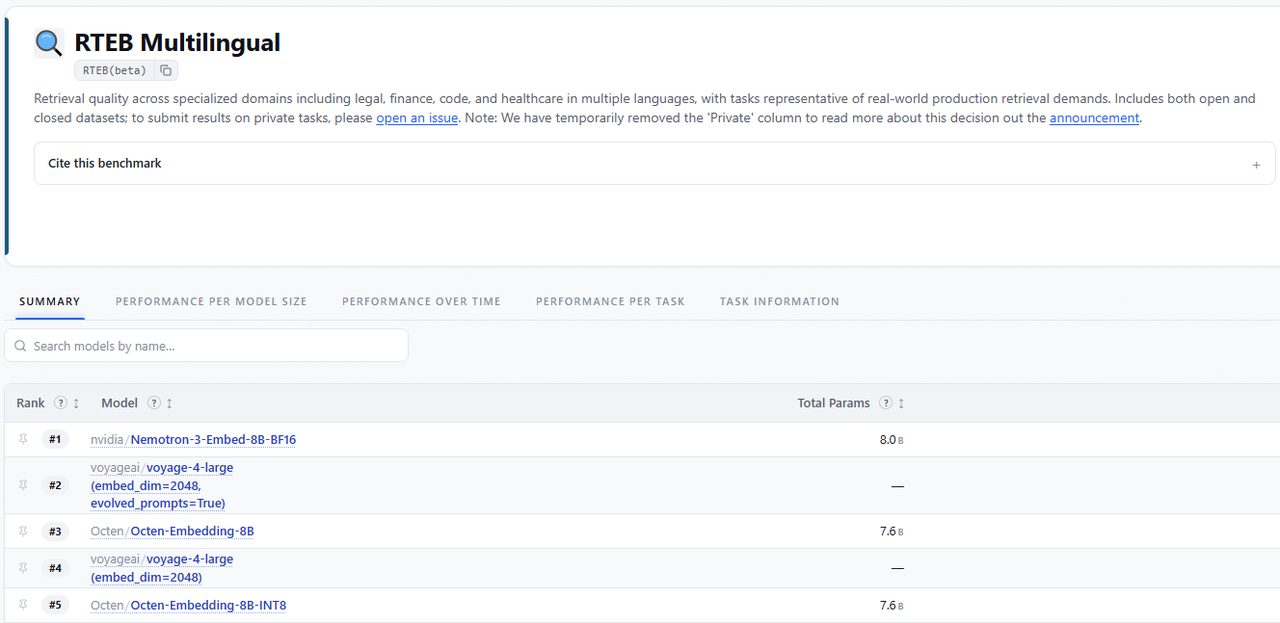 Nemotron 3 Embed atteint la #1 position au classement RTEB (Retrieval Text Embedding Benchmark) 3. Le modèle est optimisé pour le retrieval agentic, un domaine critique pour les systèmes RAG et les agents de recherche multi-étapes.
Pourquoi ça compte : gain direct sur la qualité de retrieval pour les pipelines RAG, avec un impact mesurable sur les taux de succès des agents de recherche.
🤖 RoboTTT scale le contexte visuomoteur à 8K timesteps
 RoboTTT introduit une méthode de Test-Time Training pour les politiques robotiques, atteignant 8K timesteps de contexte visuomoteur 8. Cela représente trois ordres de grandeur au-dessus des politiques existantes, sans croissance de la latence d’inférence.
Pourquoi ça compte : nouvelle capability pour les systèmes robotiques, permettant des séquences d’actions longues sans perte de performance.
À retenir
Radar Contradictions
Claim : NVIDIA Nemotron 3 Embed ranks #1 overall on RTEB, advancing agentic retrieval 3. Contre-signal : Un article du même jour montre que la performance statique d’un système de retrieval ne prédit pas son utilité causale dans un contexte multi-étapes agentique, ce qui remet en question la pertinence du benchmark RTEB pour les usages agentiques 10. Ce que ça change pour un dev : Un classement #1 sur RTEB ne garantit pas l’efficacité du modèle dans un pipeline agentique réel.
Reproduit en 15 min
Repo/Snippet : NVIDIA Nemotron 3 Embed Ranks #1 Overall on RTEB 3
Comment tester : 1. Charger le modèle viatransformersavecAutoModel.from_pretrained("nvidia/Nemotron-3-Embed"). 2. Tester l’encodage d’une phrase et comparer le score de similarité cosinus sur un jeu de requêtes agentiques.
Prérequis : Python, PyTorch, GPU (recommandé), clé Hugging Face pour accès gated.
Track Record
Partiellement tenu
Ce qu’on disait le 2026-07-03 : « Zuckerberg déclare que le développement des agents IA est plus lent que prévu » 2 Verdict aujourd’hui : Partiellement tenu. La semaine montre une accélération des déploiements agents : Cars24 gère 1M+ minutes de conversations/mois 4, Shippy publie ses apprentissages 5, et LM Studio Bionic cible les agents open-source 6. La lenteur initiale semble céder la place à des applications concrètes, sans pour autant infirmer le constat de départ.
Sous le radar
L’item : Partition, Prompt, Aggregate: Statistical Self-Consistency in Language Models 7 (arXiv, faible: 0 citation) Pourquoi c’est du signal : Formalise un test probabiliste simple (vérification d’identités conditionnelles) pour détecter quand un LLM dévie du comportement inférentiel attendu, sans nécessiter de données de calibration.
Donnée manquante
L’annonce : Inkling: Our Open-Weights Model 1 Ce qui manque : Le coût d’inférence par requête n’est pas disclosed. Pourquoi ça compte : Sans ce chiffre, impossible d’évaluer le coût réel d’exploitation par rapport à des modèles propriétaires concurrents, ce qui est critique pour un usage en production.
Sources (18) — vérifiées le 17/07/2026 11:15 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | Inkling: Our Open-Weights Model | Hacker News | 15 juillet 2026 |
| 2 | Kimi K3: Open Frontier Intelligence | Hacker News | 16 juillet 2026 |
| 3 | NVIDIA Nemotron 3 Embed Ranks #1 Overall on RTEB, Advancing Agentic Retrieval | Hugging Face | 16 juillet 2026 |
| 4 | How Cars24 scales conversations and builds faster with OpenAI | OpenAI | 16 juillet 2026 |
| 5 | What building Shippy taught us about building agents | Hugging Face | 15 juillet 2026 |
| 6 | LM Studio Bionic: the AI agent for open models | Hacker News | 16 juillet 2026 |
| 7 | Partition, Prompt, Aggregate: Statistical Self-Consistency in Language Models | arXiv | 16 juillet 2026 |
| 8 | RoboTTT: Context Scaling for Robot Policies | arXiv | 16 juillet 2026 |
| 10 | Bridge Evidence: Static Retrieval Utility Does Not Predict Causal Utility in Multi-Step Agentic Search | arXiv | 16 juillet 2026 |
Autres lectures (9)
| N° | Publication | Site | Date |
|---|---|---|---|
| 9 | SearchOS-V1: Towards Robust Open-Domain Information-Seeking Agent Collaboration | arXiv | 16 juillet 2026 |
| 11 | AutoSynthesis: An agentic system for automated meta-analysis | arXiv | 16 juillet 2026 |
| 12 | When Words Are Safe But Actions Kill: Probing Physical Danger Beyond Text Safety in Hidden-State Risk Space | arXiv | 16 juillet 2026 |
| 13 | Why teens deserve access to safe AI | OpenAI | 16 juillet 2026 |
| 14 | Connect more of your apps to Search | Google AI | 16 juillet 2026 |
| 15 | Create, edit and star in videos with two Google Vids updates | Google AI | 16 juillet 2026 |
| 16 | Newer Models, Same Advantage | Hugging Face | 16 juillet 2026 |
| 17 | Our approach to bioresilience | Google DeepMind | 16 juillet 2026 |
| 18 | Security incident disclosure — July 2026 | Hugging Face | 16 juillet 2026 |
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.